Ghiduri
Lip sync AI explicat: poze care vorbesc și dublaj video
Lip sync AI potrivește buzele cu sunetul. Află cele două utilizări, poze care vorbesc și dublaj video, ce face rezultatul credibil și cum le faci în Kubeez.
· Dex
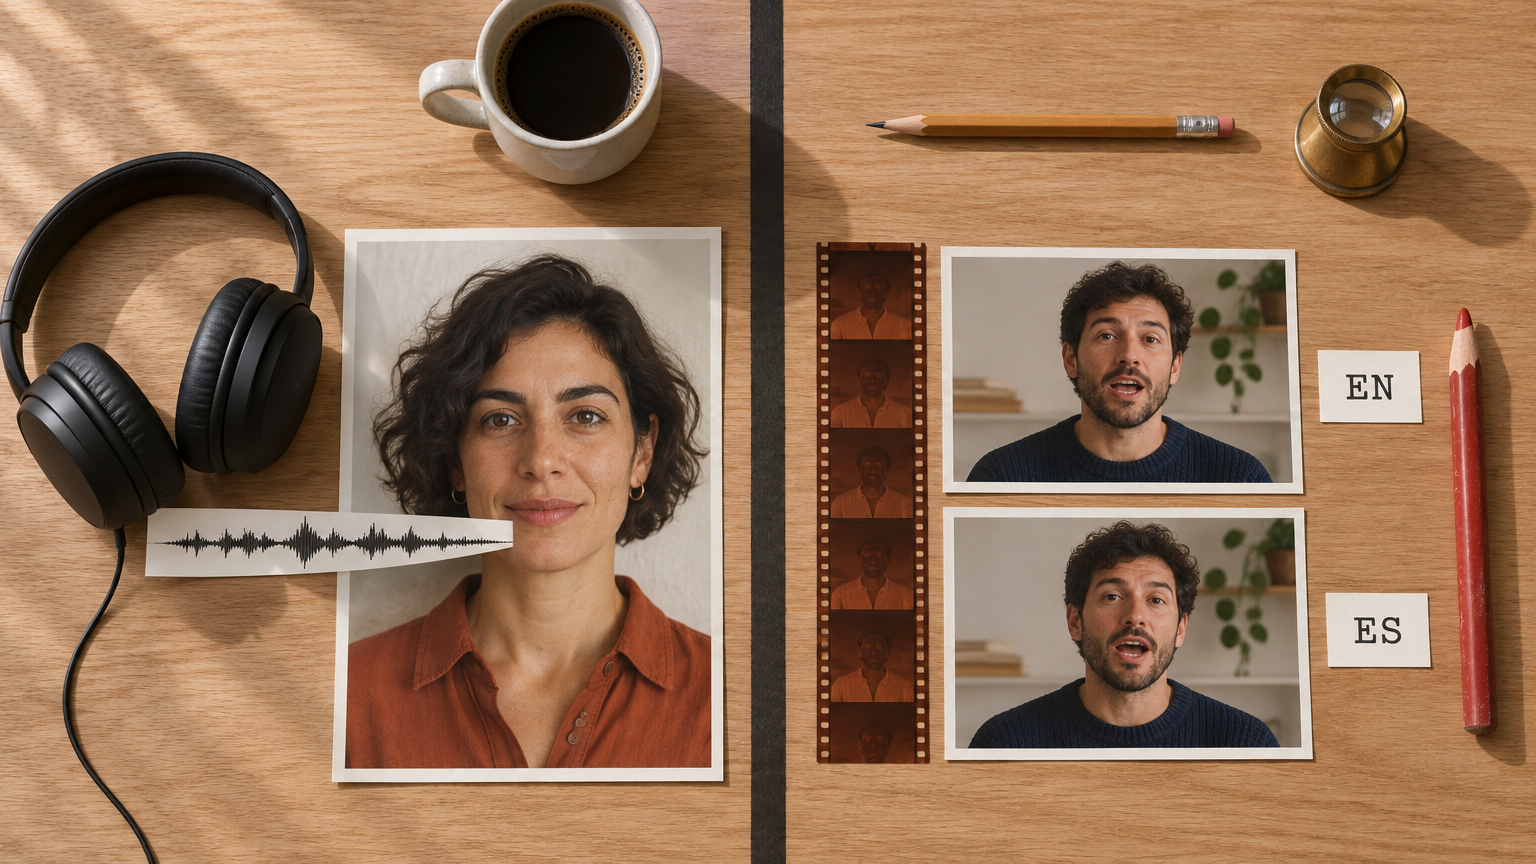
Lip sync AI, adică sincronizarea buzelor cu inteligență artificială, înseamnă un program care face ca gura unei persoane să se miște exact pe un fișier audio. Termenul acoperă de fapt două lucruri diferite. Primul: o fotografie care vorbește sau cântă. Îi dai modelului un portret și un fișier audio, iar el generează un video în care persoana din poză rostește cuvintele tale. Al doilea: resincronizarea gurii într-un video care există deja, de obicei după ce vocea a fost dublată în altă limbă. Mai jos găsești cum funcționează amândouă, ce face un rezultat să arate natural sau fals și cum le faci pe fiecare în Kubeez.
Ce este sincronizarea buzelor cu AI?
Fiecare sunet are o formă a gurii. „M” și „B” închid buzele, „O” le rotunjește, „F” aduce dinții de sus pe buza de jos. Animatorii numesc aceste forme viseme și, timp de decenii, le-au desenat sau potrivit de mână.
Un model de lip sync AI învață această corespondență din foarte multe filmări cu oameni care vorbesc. Primește un sunet și o față, ghicește ce formă trebuie să aibă gura în fiecare cadru, apoi desenează cadrele astfel încât să se potrivească cu fața, pielea și lumina persoanei. Modelele bune adaugă și detaliile care fac vorbirea credibilă: clipitul, mișcări mici ale capului și expresii care urmează tonul vocii.
Cele două lucruri pe care oamenii le numesc „lip sync AI”
Înainte să alegi o unealtă, lămurește-te ce ai de făcut. Cele două sarcini pornesc de la materiale diferite și dau rezultate diferite.
| O poză care vorbește sau cântă | Gura resincronizată într-un video existent | |
|---|---|---|
| Pornești de la | O fotografie și un fișier audio | Un video cu cineva care vorbește, plus audio nou |
| AI-ul creează | Toată interpretarea: gura, capul, privirea, expresia | Doar zona gurii, restul filmării rămâne |
| Folosire tipică | Avatare care vorbesc, prezentatori, portrete care cântă, explicații | Dublaj în altă limbă, o replică schimbată după filmare |
| Ce caută lumea | poză care vorbește AI, lip sync din fotografie | lip sync video AI, dublaj vizual |
Sarcina 1: o fotografie care vorbește
Aici modelul are un singur cadru, așa că inventează tot ce se mișcă. Buzele urmează sunetul, iar fața și capul se mișcă așa cum se mișcă la un om care vorbește. Nu poate apărea nimic din afara pozei: dacă fotografia arată doar capul și umerii, și video-ul rămâne la cap și umeri.
Sarcina 2: lip sync pe un video, pentru dublaj
Aici filmarea există deja. Scopul este să schimbi cât mai puțin: păstrezi omul, fundalul, mișcarea camerei și lumina, și redesenezi doar gura ca să se potrivească cu sunetul nou. Asta face ca un video dublat să arate ca și cum vorbitorul chiar ar vorbi noua limbă.
Cum funcționează, pe scurt
Majoritatea sistemelor de sincronizare a buzelor fac trei lucruri:
- Ascultă sunetul. Modelul transformă audio-ul într-o serie de trăsături care descriu, cadru cu cadru, ce se spune și cum.
- Prezic gura. Pentru fiecare cadru, estimează forma gurii și mișcarea din jur (maxilar, obraji, bărbie) care se potrivesc cu acele trăsături.
- Desenează fața. Generează cadre care păstrează identitatea persoanei și îmbină gura nouă cu pielea, dinții și lumina.
Partea grea este verificarea. Un articol de cercetare foarte citat, A Lip Sync Expert Is All You Need for Speech to Lip Generation In The Wild (Prajwal și colegii, 2020), a arătat că metodele mai vechi ieșeau adesea din sincron pe filmări reale cu persoane pe care nu le văzuseră la antrenare. Soluția lor a fost un „expert” în sincronizare, un model care dă notă cât de bine se potrivesc buzele cu sunetul.
Ce face ca lip sync-ul să arate bine sau prost
Modelul contează, dar cele mai multe rezultate proaste vin din materialele de intrare. Patru lucruri decid aproape totul.
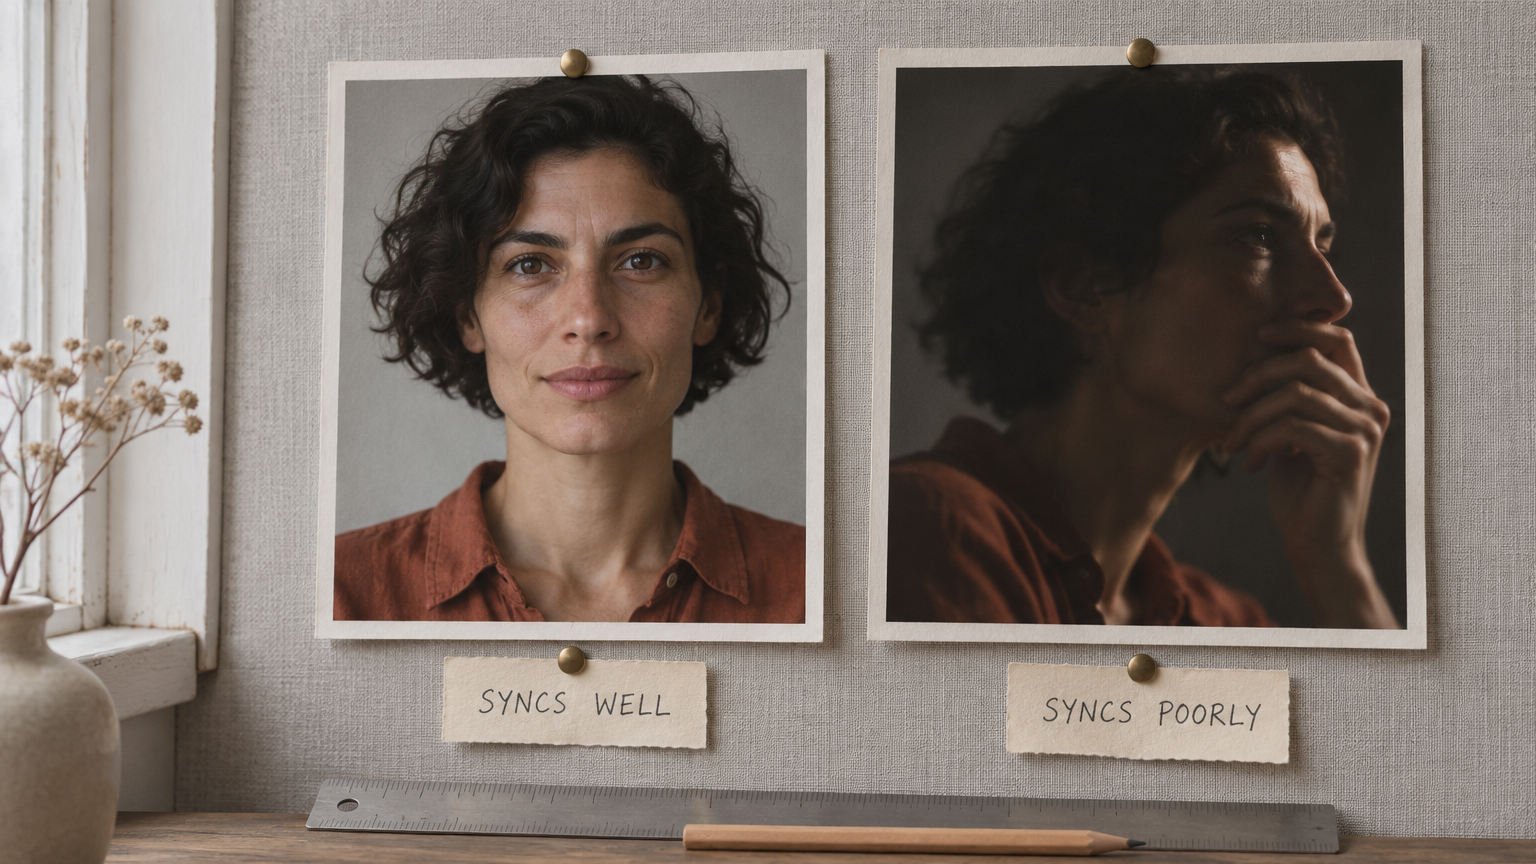
1. Calitatea sunetului
Buzele pot urma doar ce aude modelul. Vorbirea curată, fără muzică dedesubt, fără ecou și fără zgomot de fond, dă cele mai clare forme ale gurii. Cuvintele mormăite și reverberația puternică dau buze vagi, terne. Dacă generezi vocea cu text to speech, controlezi complet acest lucru. La cântece, alege o porțiune în care vocea se aude clar.
2. Unghiul și vizibilitatea feței
Cel mai bine merge o față văzută din față, cu gura complet la vedere. Cu cât capul e mai întors, cu atât modelul are mai puțină gură cu care să lucreze. O mână la bărbie, un microfon în fața buzelor, părul peste gură sau ochelarii de soare strică rezultatul.
3. Rezoluția și claritatea
Gura ocupă o parte mică din cadru. O poză sau o filmare clară, luminată uniform, îi dă modelului detalii reale pentru buze și dinți. O sursă neclară, întunecată sau foarte comprimată îl obligă să ghicească, iar asta se vede: dinți întinși și contururi moi în jurul gurii.
4. Durata clipului
Clipurile scurte ies mai ușor bine și sunt mai ieftin de refăcut. Pentru un text lung, generează câte un paragraf sau câte o scenă. Dacă o variantă iese prost, refaci zece secunde, nu trei minute. Verifică și limitele de durată ale modelului: unele modele de lip sync se opresc pe la 20 de secunde, altele acceptă câteva minute de audio.
Cum faci o poză să vorbească cu AI în Kubeez
Kubeez are două modele făcute pentru a sincroniza o fotografie cu propriul tău audio. Amândouă se plătesc pe secundă de audio, iar prețul actual apare pe cardul modelului înainte să generezi.
| OmniHuman 2.0 | P-Video | |
|---|---|---|
| Potrivit pentru | Prezentatori, explicații, portrete care cântă, clipuri mai lungi | Clipuri scurte și schițe rapide |
| Durata audio | Între 4 secunde și 5 minute | Până la 20 de secunde |
| Rezultat | 720p, cu forma fotografiei tale | 720p sau 1080p, plus variante draft mai rapide |
| Durata video-ului | Exact cât audio-ul | Exact cât audio-ul |
Pașii:
- Pregătește sunetul. Înregistrează-te, folosește o voce din off care îți aparține sau scrie replica și generează vocea în dialog și text to speech din Kubeez. Taie liniștea de la început și de la sfârșit, pentru că fiecare secundă de audio înseamnă o secundă de video plătită.
- Alege fotografia. Din față, clară, luminată uniform, cu gura vizibilă și relaxată, fără nimic peste față. Forma pozei devine forma video-ului, așa că decupeaz-o pentru locul unde vei posta.
- Deschide modelul în studio și atașează poza și fișierul audio. Pentru orice depășește 20 de secunde, folosește OmniHuman 2.0.
- Adaugă un prompt scurt (opțional). Descrie starea, mișcările mici și camera, de exemplu „cald, mici încuviințări din cap, râde la ultima replică, cadru fix”. Nu lipi textul replicii, modelul îl aude deja.
- Generează și verifică gura pe sunetele grele: „m”, „b”, „p” și „f”. Dacă acolo arată bine, de obicei și restul arată bine.
Pentru un exemplu complet, cu materialele reale și video-ul final, citește ghidul nostru pas cu pas despre cum faci o poză să vorbească sau să cânte. Articolul de lansare OmniHuman 2.0 acoperă specificațiile și folosirea prin API.
Cum dublezi un video în altă limbă în Kubeez
Dublajul video din Kubeez traduce vorbirea din clipul tău și o revocalizează în limbile pe care le alegi. Iată ce face și ce nu face, ca să știi la ce să te aștepți.
Ce face: încarci un MP4, MOV sau MP3 cu vorbire, de până la 5 minute. Alegi una sau mai multe limbi. Primești câte un fișier pentru fiecare limbă, cu aceeași imagine, aceeași muzică și aceleași efecte, iar vorbirea este înlocuită cu noua limbă.
Ce nu face: nu redesenează gura. Imaginea este filmarea ta originală, deci buzele vorbitorului se mișcă tot pe limba inițială.
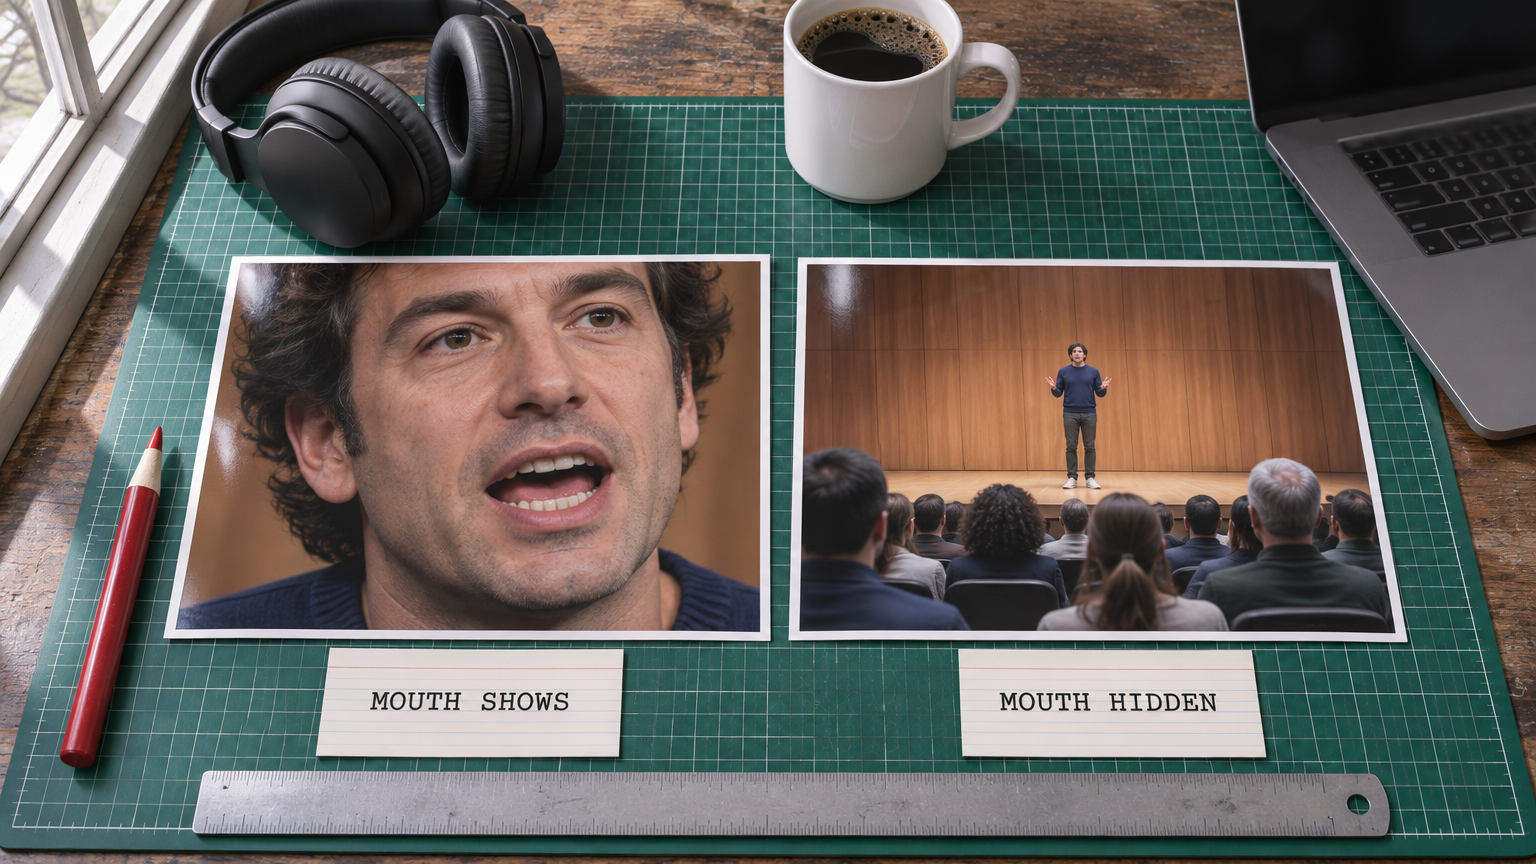
Dacă asta contează sau nu depinde de cadru:
- Gura ascunsă sau mică: voce din off peste imagini de umplutură, cadre cu produse, înregistrări de ecran, planuri largi cu o scenă, oameni filmați din spate. Aici dublajul singur arată natural, pentru că nimeni nu poate citi buzele.
- Gura mare pe ecran: prim-planuri cu cineva care vorbește, interviuri, reclame în care omul vorbește direct la cameră. Aici privitorii observă când buzele nu se potrivesc cu vorbele.
Pașii:
- Deschide dublajul video și adaugă un clip în care se vorbește clar. Dublajul rescrie vorbirea care există deja, nu adaugă voce într-un clip fără sunet.
- Alege limbile. Fiecare limbă se plătește integral, pe secundă de clip, așa că alege doar ce îți trebuie. Prețul apare înainte să pornești.
- Generează și compară. Pornește variantele dublate una lângă alta sau descarcă-le separat.
Pentru prim-planuri cu cineva care vorbește, există și altă cale. Dacă ai nevoie de un prezentator care vorbește direct la cameră în mai multe limbi, poți face fiecare versiune ca pe o poză care vorbește. Scrie sau traduce textul, înregistrează vocea în fiecare limbă (cu vocea ta sau în dialog și text to speech, dacă vocea aleasă vorbește acea limbă), apoi trece fiecare replică prin OmniHuman 2.0 cu același portret. Astfel, fiecare versiune are buze potrivite cu propria limbă. Compromisul: e o interpretare nouă, generată dintr-o singură fotografie, nu filmarea ta originală, așa că mișcarea corpului și fundalul din filmare nu se păstrează.
Consimțământul: când folosești fața sau vocea unui om real
Cu lip sync AI e ușor să pui vorbe în gura cuiva, așa că fii strict cu fețele și vocile pe care le folosești.
- Folosește-ți propria față și propria voce sau pe ale unor oameni care au fost de acord, ideal în scris, cu exact acea folosire: unde va fi publicat și pentru cât timp.
- Nu face un om real să pară că spune ceva ce n-a spus și nu imita o persoană publică sau pe cineva care nu și-a dat acordul.
- Marchează video-ul sintetic atunci când privitorii l-ar putea confunda cu o înregistrare reală.
- Legea ține pasul. În Statele Unite, legea ELVIS din Tennessee, semnată pe 21 martie 2024, a creat un drept de proprietate asupra propriei voci și răspundere civilă pentru folosirea neautorizată a vocii sau a imaginii cuiva (rezumat Covington). Regulile diferă de la o țară la alta, așa că verifică-le pe cele care ți se aplică.
Un portret generat al unei persoane care nu există evită cele mai multe dintre aceste probleme, motiv pentru care exemplele noastre folosesc unul.
Întrebări frecvente
Care e cel mai bun lip sync AI pentru o fotografie?
Depinde de durată. Pentru clipuri care vorbesc sau cântă mai mult de 20 de secunde, OmniHuman 2.0 acceptă până la 5 minute de audio pe un singur portret. Pentru clipuri scurte și schițe rapide, P-Video e mai rapid. În ambele cazuri, poza și sunetul contează mai mult decât modelul.
Poate AI-ul să sincronizeze o poză cu un cântec?
Da. Folosești cântecul ca fișier audio, iar buzele îl urmează la fel ca pe vorbire. Începe cu o porțiune în care vocea se aude clar, nu acoperită de instrumente.
Poate AI-ul să schimbe gura într-un video dublat ca să se potrivească cu noua limbă?
Asta se numește dublaj vizual, iar uneltele dedicate îl fac redesenând doar zona gurii. Dublajul din Kubeez schimbă vocea, dar păstrează imaginea originală, deci buzele rămân neschimbate. Pentru prim-planuri cu cineva care vorbește, poți face fiecare versiune ca pe o poză care vorbește.
Există lip sync AI gratuit?
Kubeez cere un cont. Conturile noi primesc o singură dată credite de bun venit, iar după aceea cumperi credite. Nu există un plan gratuit permanent. Sincronizarea buzelor se plătește pe secundă de audio, deci clipurile scurte costă mai puțin.
Merge sincronizarea buzelor pe desene animate sau pe animale?
Modelele de lip sync sunt făcute pentru fețe umane. Portretele clare și realiste ale unor oameni dau cele mai sigure rezultate. Nu te baza pe desene, personaje animate sau animale.
Este legal lip sync-ul cu AI?
În cele mai multe locuri, să faci un video cu buze sincronizate e legal. Să folosești fața sau vocea cuiva fără permisiune s-ar putea să nu fie, iar unele locuri, precum Tennessee, au legi care protejează vocea și imaginea unei persoane. Folosește fețe și voci pe care ai dreptul să le folosești.
Dex scrie ghidurile Kubeez și creează fiecare exemplu cu aceleași unelte pe care le folosești și tu.